MCPで"自分だけの相場AI"を作ってみた
ZOZO Advent Calendar 2025 カレンダー Vol.12 の 20 日目の記事です。
恒例になりつつある黒トイプー琥珀の3歳の誕生日にアドベントカレンダーを書かせてもらいます。
Happy Birthday!!

アドベントカレンダーしか記事を公開しないブログとなりつつありますね、、
毎年言っていますが来年は初心に帰ってインプット(主に勉強会の参加など)を増やしてアウトプット(感想記事)を行っていければと思っています。
古着の相場ってむずかしくない?
先日、僕が入会している某アーティストのファンクラブ配信で、アーティストの私物ブランド品のフリマ販売が行われました。
サンローランのブルゾンが30,000円、GUCCIのブーツも30,000円、ルイヴィトンのジャケットが10,000円と破格の値段でしたが残念ながら抽選にはずれてしまい、購入することはできませんでした。。。
そのような超格安販売を見ていてふと、「これ、いま買ったら後で値上がりするの?それとも下がるの?」みたいな疑問が頭をよぎりました(転売は絶対しません)。
特に最近は、
- ブランドのリバイバル
- コラボによる一時的な高騰
- モデルチェンジによる相場落ち
など、アイテムごとに動き方がけっこう違います。
ただ、僕が実際にやっているのは、メルカリを数ページ検索してなんとなくの相場感をつかんで「たぶんこのへんの値段かな?」と判断するという、わりと属人的で肌感に頼る感じです。
もちろんそれでも問題ないですが、最近のAIブームの中で、ふとこんなことを考えました。
相場の「傾向」だけでもAIに補助してもらえないか?
細かい統計モデルやMLをやるほど大げさにしたいわけではなくて、もっとざっくりした判断をAIに持たせたい。
たとえば、
- COMME des GARÇONS のベーシックTは年式が多少古くても需要が落ちない
- ACG のアウターは2010年代前半の値動きが独特
- スニーカーはリリース年とカラーで上下の差が激しい
- GUCCI のバッグは年式が古いと一気に相場が落ちることがある
こういうジャンルごとの傾向はAI とデータがセットになるとかなり得意領域になります。
そこで今回試してみたのが、「古着・ブランド価格リスク判定MCP」 という仕組みです。
MCP(Model Context Protocol)を使うことで、自分で作ったミニDB(SQLite)をAIの“外部ツール”として扱い、ブランド×アイテム×年式の入力から、「いま買うと価値が上がりそうか/下がりそうか」を返せるようにしていきます。
投資ではなく、あくまで“相場の傾向をデータとして扱うための実験”という位置づけです。
これを作ってみると、思った以上に手軽に「AIの相場アシスト」が実現できたので、この記事ではその作り方を順番に紹介していきます。
まずはミニ相場DBを作る:SQLiteでブランド × アイテム × モデル名 × 色 × サイズを管理
「相場をAIに判断させる」と聞くと難しく感じますが、最初は 手元のミニDB(SQLite) だけあれば十分です。
古着やスニーカー市場は、同じブランド・同じアイテムでも “モデル名・カラー・サイズ” で価値が激変する世界です。
そのため今回のミニDBでは、以下の7つの軸で管理することにしました。
- ブランド(brand)
- アイテムタイプ(item_type)
- 商品名・モデル名(model_name)
- 色(color)
- サイズ(size)
- 年式(year)
- 平均相場(avg_price)
これだけでも、それっぽい相場感が出せます。
SQLite を作る
まずDB本体を作ります。
sqlite3 items.db
SQLite のプロンプトが開いたら、以下のテーブル作成SQLを流します。
テーブル構造(色・サイズ・モデル名まで含む)
CREATE TABLE items (
  id INTEGER PRIMARY KEY AUTOINCREMENT,
  brand TEXT NOT NULL,
  item_type TEXT NOT NULL,
  model_name TEXT,
  color TEXT,
  size TEXT,
  year INTEGER,
  avg_price REAL,
  currency TEXT
);
- model_name
- “Dunk Low Retro Panda” / “Box Logo Tee” / “Classic Leather” などの商品名
- color
- 黒 / 白 / Red / “Black/White” など
- size
- Tシャツ:M / L
- スニーカー:27.5 / 28
- バッグ:Small / Medium etc.
扱うジャンルによって揺れがあるので、TEXT型で柔軟にしておくのがポイント。
とりあえず数件だけでも十分
まずは、動かすためのダミーデータです。
※実在の相場ではありません(例示用)。
INSERT INTO items (brand, item_type, model_name, color, size, year, avg_price, currency)
VALUES
  ('Supreme', 'T-shirt', 'Box Logo Tee', 'White', 'L', 2021, 21000, 'JPY'),
  ('Supreme', 'T-shirt', 'Box Logo Tee', 'Black', 'L', 2020, 24000, 'JPY'),

  ('Nike', 'Sneakers', 'Dunk Low Retro "Panda"', 'Black/White', '27.5', 2020, 28000, 'JPY'),
  ('Nike', 'Sneakers', 'Dunk Low Retro "Panda"', 'Black/White', '28.0', 2021, 32000, 'JPY'),

  ('GUCCI', 'Bag', 'GG Marmont Matelassé Small', 'Black', NULL, 2019, 120000, 'JPY'),
  ('GUCCI', 'Bag', 'GG Marmont Matelassé Small', 'Beige', NULL, 2018, 110000, 'JPY'),

  ('COMME des GARÇONS', 'T-shirt', 'Heart Logo Tee', 'White', 'M', 2022, 9000, 'JPY'),
  ('COMME des GARÇONS', 'T-shirt', 'Heart Logo Tee', 'Black', 'L', 2020, 12000, 'JPY');
これだけでも、「ブランドの傾向 + モデルの人気 + カラー人気 + サイズ人気」が相場にどう効いているかがなんとなく見えるデータになります。
中身を確認
SELECT brand, item_type, model_name, color, size, year, avg_price
FROM items;
数行入っていればOKです。
どう使うのか?
次章で作る MCPサーバー は、ユーザーから受け取った情報(例:ブランド=Nike、アイテム=スニーカー…)を元に、
という流れで動きます。
つまりこの items.db が、AIが“相場のクセ”を学習するためのミニ辞書の役割を果たします。
"古着・ブランド価格リスク判定MCP" を最小構成で作る
ここからは、いよいよ MCPサーバー本体 を作っていきます。
やることはシンプルで、
- Node.js で MCP サーバーを立ち上げる
- さきほど作った
items.db(SQLite)を読み込む - ブランド / アイテム / 年式 などの条件で検索
- 「上がりそう/下がりそう」のざっくり評価を返すツールを作る
という流れです。
ここでは あくまで"最小構成のサンプル"に絞ります。
プロジェクトの準備
まずは適当なディレクトリを作ります。
mkdir vintage-risk-mcp
cd vintage-risk-mcp
npm init して最低限の設定をします。
npm init -y
次に、必要なライブラリを入れます。
- SQLite 用:sql.js(Pure JavaScript実装でネイティブビルド不要)
- MCP 用:@modelcontextprotocol/sdk
npm install sql.js
npm install @modelcontextprotocol/sdk
TypeScript にしたい場合は typescript / ts-node なども入れればよいですが、ここでは シンプルに Node.js(CommonJS or ES Modules)で動く前提のサンプルにしておきます。
Note:
better-sqlite3はネイティブモジュールのため、Node.js のバージョンによってはビルドエラーが発生することがあります。sql.jsは Pure JavaScript 実装なので、環境を選ばず動作します。
ファイル構成(最小)
とりあえずこんなイメージです。
vintage-risk-mcp/
  ├─ items.db          # 作ったSQLiteファイルをここにコピー
  ├─ package.json
  └─ server.mjs        # MCPサーバー本体(ES Modules形式)
package.json の例
必要に応じて "type": "module" をつけておきます。
{
  "name": "vintage-risk-mcp",
  "version": "0.1.0",
  "type": "module",
  "main": "server.mjs",
  "scripts": {
    "start": "node server.mjs"
  },
  "dependencies": {
    "@modelcontextprotocol/sdk": "^1.0.0",
    "sql.js": "^1.10.0"
  }
}
バージョンは実際のSDKや環境に合わせて調整してください。
リスク判定の考え方(ゆるいロジック)
ここではあくまで「相場の“傾き”をざっくり見るだけ」のロジックにします。
入力として受け取るのは、だいたいこのあたり:
- brand(ブランド名)
- item_type(T-shirt, Sneakers, Bag …)
- year(買おうとしているアイテムの年式)
- あれば:model_name, color, size
これをもとに、SQLiteから近いレコードを取ってきて、以下のような判定をします。
ざっくりアルゴリズム例:
- 同じブランド & アイテムタイプのデータを取得(必要に応じて model_name・color・size を絞る)
- year が小さい順にソートして、価格推移をざっと見る
- 直近数年の平均価格の変化率を見る
- 変化率に応じて:
- 上昇傾向 → trend: "up", risk: "low"
- 横ばい → trend: "flat", risk: "medium"
- 下降傾向 → trend: "down", risk: "high"
もちろん、本気でやるならもっと複雑にできますが、記事の段階ではこのくらいの“ゆるさ”がちょうどいいです。
server.mjs(MCPサーバー本体)
以下が実際に動作するMCPサーバーのコードです。
// server.mjs

import { Server } from '@modelcontextprotocol/sdk/server/index.js';
import { StdioServerTransport } from '@modelcontextprotocol/sdk/server/stdio.js';
import {
  CallToolRequestSchema,
  ListToolsRequestSchema,
} from '@modelcontextprotocol/sdk/types.js';
import initSqlJs from 'sql.js';
import { readFileSync } from 'fs';
import { fileURLToPath } from 'url';
import { dirname, join } from 'path';

const __filename = fileURLToPath(import.meta.url);
const __dirname = dirname(__filename);

// SQLite を開く
const SQL = await initSqlJs();
const dbBuffer = readFileSync(join(__dirname, 'items.db'));
const db = new SQL.Database(dbBuffer);

// MCPサーバーを初期化
const server = new Server(
  {
    name: 'vintage-price-risk',
    version: '0.1.0',
  },
  {
    capabilities: {
      tools: {},
    },
  }
);

// ツール一覧を返すハンドラ
server.setRequestHandler(ListToolsRequestSchema, async () => {
  return {
    tools: [
      {
        name: 'judge_vintage_price_risk',
        description:
          'ブランド古着の相場傾向から、価格リスク(上がりそう/下がりそう)をざっくり判定する。',
        inputSchema: {
          type: 'object',
          properties: {
            brand: { type: 'string', description: 'ブランド名' },
            item_type: { type: 'string', description: 'アイテム種別(T-shirt, Sneakers, Bag など)' },
            model_name: { type: 'string', description: '商品名・モデル名' },
            color: { type: 'string', description: '色' },
            size: { type: 'string', description: 'サイズ' },
            year: { type: 'number', description: 'アイテムの年式' },
          },
          required: ['brand', 'item_type'],
        },
      },
    ],
  };
});

// ツール実行ハンドラ
server.setRequestHandler(CallToolRequestSchema, async (request) => {
  if (request.params.name !== 'judge_vintage_price_risk') {
    throw new Error(`Unknown tool: ${request.params.name}`);
  }

  const { brand, item_type, model_name, color, size, year } = request.params.arguments;

  // 1. ベースとなるクエリを組み立てる
  let query = `
    SELECT year, avg_price
    FROM items
    WHERE brand = ?
      AND item_type = ?
  `;
  const params = [brand, item_type];

  // 任意項目で少しずつ絞り込む(あれば使う)
  if (model_name) {
    query += ` AND model_name = ?`;
    params.push(model_name);
  }
  if (color) {
    query += ` AND color = ?`;
    params.push(color);
  }
  if (size) {
    query += ` AND size = ?`;
    params.push(size);
  }

  query += ` ORDER BY year ASC`;

  const result = db.exec(query, params);
  const rows = result.length > 0 ? result[0].values.map(row => ({ year: row[0], avg_price: row[1] })) : [];

  // 2. データが少なすぎる場合
  if (rows.length < 2) {
    return {
      content: [
        {
          type: 'text',
          text: JSON.stringify({
            risk: 'unknown',
            trend: 'unknown',
            score: 0.0,
            reason:
              '該当データが少なすぎるため、価格リスクを判定できませんでした。ブランドや条件を変えてみてください。',
            sampleYears: rows.map((r) => r.year),
          }),
        },
      ],
    };
  }

  // 3. 推移をざっくり計算する(最後と最初の比だけ見るシンプル版)
  const first = rows[0];
  const last = rows[rows.length - 1];

  const diff = last.avg_price - first.avg_price;
  const rate = diff / first.avg_price; // 変化率

  let trend = 'flat';
  let risk = 'medium';
  let score = 0.5;

  if (rate > 0.15) {
    trend = 'up';
    risk = 'low';
    score = 0.8;
  } else if (rate < -0.15) {
    trend = 'down';
    risk = 'high';
    score = 0.2;
  }

  // 年式指定があれば、それも軽くコメントに反映する
  let yearComment = '';
  if (year) {
    const closest = rows.reduce((prev, curr) => {
      return Math.abs(curr.year - year) < Math.abs(prev.year - year) ? curr : prev;
    });
    yearComment = `指定された年式 ${year} 年に最も近いデータは ${closest.year} 年の平均相場 ${closest.avg_price} 円です。`;
  }

  // 4. 結果を返す
  return {
    content: [
      {
        type: 'text',
        text: JSON.stringify({
          risk,
          trend,
          score,
          rate,
          sampleYears: rows.map((r) => r.year),
          reason: `ブランド「${brand}」の「${item_type}」について、初期の平均相場 ${first.avg_price} 円から直近の平均相場 ${last.avg_price} 円へ変化しています(変化率: ${(rate * 100).toFixed(1)}%)。${yearComment}`,
        }),
      },
    ],
  };
});

// MCPサーバーを起動(標準入出力で待ち受け)
async function main() {
  const transport = new StdioServerTransport();
  await server.connect(transport);
  console.error('Vintage Price Risk MCP server running on stdio');
}

main().catch(console.error);
ざっくり動作イメージ
この MCP サーバーが立ち上がると、Claude(MCP対応クライアント)からは、だいたいこんなイメージで呼ばれます。
Claude に:
「Nike の Dunk Low Panda で、スニーカー、サイズ 27.5、2020年あたりの相場の傾向を見て。上がりそうか、下がりそうかざっくり教えて。」
Claude は judge_vintage_price_risk ツールを呼び出し、brand="Nike", item_type="Sneakers", … を渡す
- MCPサーバーが SQLite を検索して、JSON で risk, trend, score, reason を返す
- Claude がそれを読み取り、人間向けの文章でまとめ直す
という流れです。
この章のゴール
この章のゴールは、SQLite のミニDBをMCPを通じて「古着・ブランド価格リスク判定ツール」として公開できるというところまで持っていくことでした。
ロジック自体はものすごく単純ですが、「自分で定義した相場ロジックを、AIのツールとして組み込めた」というところが一番大きなポイントです。
Claude に聞いてみる:「このアイテム、今買うとどう?」
ここまでで、
が用意できました。
この章では、いよいよ Claude 側からこのMCPを呼び出して使ってみる パートです。
ざっくり全体像
やりたいことはシンプルです。
- ユーザーが Claude に自然言語で質問する
- Claude が「この質問には
judge_vintage_price_riskツールを使うのが良さそう」と判断 - MCPサーバーに対して、必要なパラメータを投げる
- MCPサーバーが SQLite を検索し、リスク判定結果を JSON で返す
- Claude がその JSON を読み、日本語の解説に変換して返してくれる
最終的に人間から見えるのは、 「AIが過去の相場を見ながらコメントしているような回答」です。
想定プロンプト例①:シンプルな例
まずは、Supreme の Tシャツから。
「Supreme の Box Logo Tee で、白の L サイズ、2021年のモデルって、
いま買うと相場的にどう?上がりそう、それとも下がりそう?」
Claude の内部では、だいたいこんなパラメータで judge_vintage_price_risk が呼ばれているイメージです。
{
  "brand": "Supreme",
  "item_type": "T-shirt",
  "model_name": "Box Logo Tee",
  "color": "White",
  "size": "L",
  "year": 2021
}
MCPサーバー側は、この条件をもとに items テーブルを検索します。
MCPサーバーからのレスポンス例(イメージ)
例えば、こんな JSON が返ってくるとします。
{
  "risk": "low",
  "trend": "up",
  "score": 0.78,
  "rate": 0.21,
  "sampleYears": [2020, 2021],
  "reason": "ブランド「Supreme」の「T-shirt」について、初期の平均相場 21000 円から直近の平均相場 25500 円へ変化しています(変化率: 21.0%)。指定された年式 2021 年に最も近いデータは 2021 年の平均相場 25500 円です。"
}
これをそのまま人間に見せるとちょっと無骨なので、Claude がいい感じに自然文にまとめてくれます。
Claude の回答イメージ
例えば、こんな感じになりえます:
Supreme の Box Logo Tee(White / L / 2021年)について、過去データを見ると平均相場はおよそ 21,000円 → 25,500円 と 約21% 上昇 しています。
直近までの推移だけ見ると 緩やかに値上がり傾向 にあり、いまの水準で購入するリスクはそこまで高くない、という判定になりました。
もちろん市場全体のトレンドやコンディションにもよりますが、「相場が大きく崩れているカテゴリ」ではない、という程度のニュアンスで捉えてもらえれば良いと思います。
MCPが「数字ベースの評価」を担当し、Claude が「文章化・解釈」を担当するイメージです。
想定プロンプト例②:スニーカー・サイズ込み
次に、スニーカーの例を見てみます。
「Nike の Dunk Low Retro 'Panda' で、ブラック/ホワイト、27.5cm、2020年頃の相場って今後どうなりそう?ざっくり傾向だけ教えて。」
内部的には、こういう呼び出しになるイメージです。
{
  "brand": "Nike",
  "item_type": "Sneakers",
  "model_name": "Dunk Low Retro \"Panda\"",
  "color": "Black/White",
  "size": "27.5",
  "year": 2020
}
もし items.db に、
- 2018年:19,000円
- 2020年:28,000円
- 2021年:32,000円
みたいなデータが入っていれば、かなり強い上昇トレンドとして判定されるはずです。
Claude の回答イメージ(スニーカー)
Nike Dunk Low Retro "Panda"(Black/White / 27.5cm)について、手元の相場データでは 2018年から2021年にかけて 約19,000円 → 約32,000円 と価格が上昇しており、全体としては強めの上昇傾向になっています。
この傾向だけ見ると、短期的に「暴落リスクが高いカテゴリ」というよりは、「人気が続いているモデル」寄りの動きです。
もちろん再販やモデルチェンジで変わる可能性はありますが、過去数年のデータだけで見れば、いまの価格で買うリスクは比較的低め という判定になります。
このように、数字を“文章の温度感”に変換するところをAIに任せるのがポイントです。
条件があいまいな場合はどうなる?
例えば、以下のようにざっくりした質問をすることもできます。
「COMME des GARÇONS の Tシャツ全般で、最近の相場って上がってる印象?下がってる印象?年式まではあまり気にしてない。」
この場合、Claude が
- brand = "COMME des GARÇONS"
- item_type = "T-shirt"
だけを渡して、model_name や color は指定せずに呼び出す、という動きをしてくれるかもしれません。
MCPサーバー側では「該当件数が少ない」「バラつきが大きい」などの状況もふまえて、
- risk: "unknown"
- trend: "flat"
などを返すようにしておくと、Claude側でちゃんと
「データがまだ少なめなので断言はできませんが、現時点の傾向としては…」
のようなニュアンスをつけて説明してくれます。
実際に使ってみると見えてくること
実際にいくつかパターンを試すと、
- 「ブランド × アイテム」だけだと大雑把すぎる
- 「モデル名・カラー・サイズ」まで入れると、それっぽい話になる
- データの行数が少ないとすぐに unknown 判定になる
- 逆に、データが増えてくると“相場のクセ”がはっきり見え始める
といった感覚が分かってきます。
この「データが増えるほど相場感が育っていく」感覚は、実際に試してみるとけっこう楽しいポイントです。
この章のまとめ
この章では、実際に Claude から
「このアイテム、今買うとどう?」
と聞いてみたときの
という一連の流れを見てきました。
MCPが “数字とロジック” を、Claude が “文章と解釈” を担当することで、「自分で定義した相場判定ロジックを、会話の中で使えるようになる」というのが一番のポイントです。
使ってみて気づいたこと & 「データを自動で集めてDBを作る」ならどうする?
ここまでで、 ミニ相場DB(SQLite) → MCP → Claude という流れで、
「このアイテム、今買うとどう?」
を AI にざっくり判定させる仕組みが完成しました。
実際に動かしてみると、 いくつか気づきや改善点、そして 「これ、もっと実用的にするならどうしたらよい?」 という考えも自然と湧いてきます。
この章では、そのあたりをゆるくまとめながら、最後に「データを自動で集めてDBを作る」アイデアまで触れていきます。
まず使ってみて感じたこと
1. モデル名・カラー・サイズはやっぱり重要
古着・スニーカー市場は “個別の特徴で値動きが変わる”世界なので、この3つを入れたことで判定の説得力が一気に上がります。
2. データが少ないとすぐに unknown 判定になる
これはSQLiteの行数を増やせば解決します。
逆にいうと「自分専用の相場データが増えるほど、AIが賢くなる」感じが楽しい。
3. 判定ロジックはシンプルで十分
複雑な回帰や機械学習をする必要はなく、「過去の平均相場の推移を見るだけ」で意外と"人間っぽい"判断が返ってきます。
今後やりたい改善ポイント
ここからは、もっと現実的に使えるための改善案です。
改善1:データ件数を増やす(精度アップの王道)
- モデル名・カラーごとに最低3年ぶん
- サイズ違い(スニーカー)は3〜5サイズ
- バッグなら状態(美品 / 使用感あり)も欲しい
DBが育つほど、AIが「相場のクセ」を掴む速度が速くなるのが面白いところ。
改善2:「コンディション」を追加したくなる
古着は状態がすべてです。
例えば:
- 新品
- 未使用に近い
- 目立った傷汚れなし
- 使用感あり
これを DB に追加するだけで、より"それっぽい"相場判定になります。
改善3:年式じゃなく「リリースシーズン」に対応したい
スニーカーやデザイナーズブランドは、FW(秋冬)/ SS(春夏)で相場が違うことがあります。
例えば:
- FW のコートはリリース年よりシーズンの方が重要
- SS のTシャツは夏前に値段が上がる
- スニーカーは“初回発売年”が重要
後からカラム追加すれば大丈夫なので、SQLite の柔軟性が活きます。
「検索して対象データを集めてDBを作る」ならどうする?
この記事で一番触れたかった部分かもしれません。
将来的に、手作業でデータを追加するのではなく、検索して集めてDBを作る という方向にも広げられます。
ここでは主要な方法を3つ紹介します。
方法1:公式API(あるなら)を使う
もし利用しているサービスに公式API があれば、それが一番安全で確実です。
- StockX(非公式APIが有名だけど公式も一部あり)
- Grailed(APIあり)
- eBay(API豊富)
- 国内なら一部の小規模マーケットにAPIが存在
APIで検索 → JSONをSQLiteに入れるだけで以下が自動化できます:
- ブランドで検索
- モデルごとの相場を取得
- 最新の販売価格を更新
- データ差分だけ更新
方法2:スクレイピング(規約に注意)
メルカリやラクマなど、HTMLスクレイピングは禁止 or グレー なケースが多いです。
そのためブログで明確に推奨はできませんが、
一般論としては:
- Playwright / Puppeteer でブラウザ経由の取得
- BeautifulSoup / Cheerio でHTML解析
- “出品中価格” ではなく “売却済み価格” を対象にする
などがあります。
ただし、規約がNGな場合は絶対にやらないのが前提です。
自動データ収集 → SQLite更新 の例(擬似コード)
SQLite を自動で更新する流れの疑似コードも載せておきます。
import initSqlJs from 'sql.js';
import { readFileSync, writeFileSync } from 'fs';

async function updateDbFromApi(apiResults) {
  const SQL = await initSqlJs();
  const dbBuffer = readFileSync('./items.db');
  const db = new SQL.Database(dbBuffer);

  const insert = db.prepare(`
    INSERT INTO items
    (brand, item_type, model_name, color, size, year, avg_price, currency)
    VALUES (?, ?, ?, ?, ?, ?, ?, ?)
  `);

  for (const row of apiResults) {
    insert.run([
      row.brand,
      row.item_type,
      row.model_name,
      row.color,
      row.size,
      row.year,
      row.avg_price,
      row.currency
    ]);
  }

  insert.free();

  // 更新したDBをファイルに書き戻す
  const data = db.export();
  writeFileSync('./items.db', Buffer.from(data));
  db.close();
}
これを
と繋げると「自動でミニ相場DBが育っていく」 世界が実現できます。
この章のまとめ
- 最初はミニDBでも、データが増えるほどAIが賢くなる
- モデル名・色・サイズを入れると判定の“実在感”が増す
- データ収集の自動化は、API → DB更新が最も現実的
- 企業データを使えば一気にレベルアップも可能
- SQLite なので構造変更も簡単で、育てるのが楽しい
そして何より、
「相場感」という“肌感覚”の部分を、AIと自作DBで再現できるという面白さ
ここに尽きるかもしれません。
最後に
今回作った 古着・ブランド価格リスク判定MCP は、まだまだ原始的な仕組みですが、
- 自分の価値観
- 自分の相場観
- 自分のデータ
を AI に持たせる第一歩としてはちょうどよい題材でした。
実験素材としても遊びとしても優秀なので、ぜひ SQLite の行数を増やしながら、自分だけの「相場AI」を育ててみてください。
k6で気軽に負荷試験を実行してみよう!
ZOZO Advent Calendar 2024 カレンダー Vol.8 の 20 日目の記事です。
今年も黒トイプードル琥珀の2歳の誕生日にアドベントカレンダーを書くことができました。
Happy Birthday!!

k6とは
Grafana Labs社が開発している負荷試験ツールです。
k6はオープンソースのCLIツールですが、 「Grafana Cloud k6」というクラウドベースSaaSツールも提供されています。
Golangで開発されていますが、テストシナリオはJavaScriptで書けるので導入敷居も低くく試しやすい特徴があると思います。
では、早速試していきましょう。
負荷試験対象のエンドポイント
今回はバグ管理システムをイメージした次のAPIをテストすることとします。
(アプリケーションのサンプルコード等は端折らせていただきます)
- GET /bugs:バグ一覧検索
- GET /bugs/{id}:バグ検索(単体)
- POST /bugs:バグの登録
- DELETE /bugs/{ID}:バグ削除
- POST /bugs/{id}/comments:コメントの書き込み
実行環境
ありがたいことにDockerイメージが用意されているので利用させていただきます。
compose.yamlでアプリケーションの起動とセットで用意していきます。
  app:
    build:
      context: .
    ports:
      - "8080:8080"
    healthcheck:
      test: "curl --fail --silent localhost:8080/health | grep UP || exit 1"
      interval: 1s
      timeout: 10s
      retries: 30

  k6:
    image: grafana/k6:latest
    container_name: k6
    working_dir: /work
    volumes:
      - ./scripts:/scripts
      - ./docs:/work
    ports:
      - "6565:6565"
    depends_on:
      app:
        condition: service_healthy
    profiles:
      - k6
シナリオの作成
冒頭でも説明しましたが、シナリオはJavaScriptで作成します。
Docker composeのvolumesで指定した「scripts」に「scenario.js」を作成します。
import http from 'k6/http';
import { sleep, check } from 'k6';
import { scenario, vu } from 'k6/execution';
import { htmlReport } from "https://raw.githubusercontent.com/benc-uk/k6-reporter/main/dist/bundle.js";
import { textSummary } from "https://jslib.k6.io/k6-summary/0.0.1/index.js";

export const options = {
    scenarios: {
        'scenarios': {
            executor: 'ramping-vus',
            startTime: '2s',
            gracefulStop: '5s',
            startVUs: 2,
            stages: [
                {duration: '10s', target: 3},
                {duration: '10s', target: 5},
                {duration: '10s', target: 0},
            ]
        },
    },
    thresholds: {
        http_req_failed: ['rate<0.01'],
        http_req_duration: ['p(95)<300'],
    },
};

const BASE_URL = 'http://app:8080';
const SLEEP_DURATION = 0.5;

export default function () {
    // バグの作成
    const postResponse = http.post(BASE_URL + '/v1/bugs', JSON.stringify({
        title: 'title' + scenario.iterationInTest,
        content: 'content' + scenario.iterationInTest,
        account_id: vu.idInTest,
    }), {
        headers: {
            'Content-Type': 'application/json',
        },
    });
    check(postResponse, {
        'is status 201': (r) => r.status === 201,
    });
    let bugUri = postResponse.headers['Location'];

    sleep(SLEEP_DURATION);

    // バグの検索
    const getResponse = http.get(BASE_URL + bugUri);
    check(getResponse, {
        'is status 200': (r) => r.status === 200,
    });

    sleep(SLEEP_DURATION);

    // バグの複数検索
    const getAllResponse = http.get(BASE_URL + '/v1/bugs');
    check(getAllResponse, {
        'is status 200': (r) => r.status === 200,
    });

    sleep(SLEEP_DURATION);

    // バグの削除
    const deleteResponse = http.del(BASE_URL + bugUri);
    check(deleteResponse, {
        'is status 204': (r) => r.status === 204,
    });
}

export function handleSummary(data) {
    let returnData = {
        stdout: textSummary(data, { indent: " ", enableColors: true })
    };

    let outputDatetime = formatDate(new Date(), 'yyyyMMdd_HHmmss');
    let outputHtml = outputDatetime + "_summary.html";
    returnData[outputHtml]=htmlReport(data);

    return returnData;
}

function formatDate (date, format) {
    format = format.replace(/yyyy/g, date.getFullYear());
    format = format.replace(/MM/g, ('0' + (date.getMonth() + 1)).slice(-2));
    format = format.replace(/dd/g, ('0' + date.getDate()).slice(-2));
    format = format.replace(/HH/g, ('0' + date.getHours()).slice(-2));
    format = format.replace(/mm/g, ('0' + date.getMinutes()).slice(-2));
    format = format.replace(/ss/g, ('0' + date.getSeconds()).slice(-2));
    format = format.replace(/SSS/g, ('00' + date.getMilliseconds()).slice(-3));
    return format;
}
シナリオの説明
scenariosで設定している内容が負荷試験のシナリオ条件になります。
設定内容は次のようになっています。
- 開始2秒はリクエストは送らない
- 2秒経過後は時間経過とともにユーザが増える
- 開始10秒で0.5秒間ウエイトを置いてリクエストを送るユーザが2から3まで段階的に増える
- 開始20秒から30秒でユーザが3から5まで段階的に増える
- 開始30秒から10秒かけて段階的にユーザが減少する
徐々にユーザ数を増やしてリクエスト数も増えていくシナリオです(ユーザ数や実施時間が短いのはローカル上で動かしているため)。
thresholdsはテスト対象サービスの期待性能の合格・不合格を判断するしきい値を設定しています。
- rate<0.01:エラーが1%を超えない
- p(95)<300:リクエストの95%は300ms以下であること
このしきい値があることで健全性をチェックすることも可能になります。
実行
Docker composeでシナリオファイルを指定し実行します。
実行すると次のようにテスト結果が出力されます。
ただ今回は handleSummaryメソッドでHtmlレポート出力を設定しているので、docsディレクトリにもレポートが出力されます。
❯ docker compose run --rm -T k6 run - < scripts/scenario.js
[+] Running 1/1
 ✔ Container app-1    Started                                                                                                                                                                               0.1s

         /\      Grafana   /‾‾/
    /\  /  \     |\  __   /  /
   /  \/    \    | |/ /  /   ‾‾\
  /          \   |   (  |  (‾)  |
 / __________ \  |_|\_\  \_____/

     execution: local
        script: -
        output: -

     scenarios: (100.00%) 1 scenario, 5 max VUs, 37s max duration (incl. graceful stop):
              * scenarios: Up to 5 looping VUs for 30s over 3 stages (gracefulRampDown: 30s, startTime: 2s, gracefulStop: 5s)

time="2024-12-19T05:50:26Z" level=info msg=setup source=console

~~ 略 ~~

running (33.0s), 1/5 VUs, 55 complete and 0 interrupted iterations
scenarios ↓ [ 100% ] 1/5 VUs  30s
time="2024-12-19T05:50:59Z" level=info msg=teardown source=console
time="2024-12-19T05:50:59Z" level=info msg="[k6-reporter v2.3.0] Generating HTML summary report" source=console
     ✓ is status 201
     ✓ is status 200
     ✓ is status 204

     checks.........................: 100.00% ✓ 280      ✗ 0
     data_received..................: 523 kB  16 kB/s
     data_sent......................: 35 kB   1.1 kB/s
     http_req_blocked...............: avg=83.88µs  min=1.04µs med=9.27µs   max=2.97ms   p(90)=203.51µs p(95)=276.43µs
     http_req_connecting............: avg=43.28µs  min=0s     med=0s       max=1.21ms   p(90)=145.79µs p(95)=192.45µs
   ✓ http_req_duration..............: avg=23.16ms  min=3.81ms med=12.76ms  max=299.11ms p(90)=50.36ms  p(95)=61.91ms
       { expected_response:true }...: avg=24.31ms  min=3.81ms med=11.69ms  max=299.11ms p(90)=52.97ms  p(95)=65.59ms
   ✗ http_req_failed................: 20.00%  ✓ 56       ✗ 224
     http_req_receiving.............: avg=323.89µs min=7.58µs med=364.31µs max=1.53ms   p(90)=657.65µs p(95)=733.17µs
     http_req_sending...............: avg=38.71µs  min=3.54µs med=25.95µs  max=597.33µs p(90)=66.02µs  p(95)=91.87µs
     http_req_tls_handshaking.......: avg=0s       min=0s     med=0s       max=0s       p(90)=0s       p(95)=0s
     http_req_waiting...............: avg=22.8ms   min=3.54ms med=12.41ms  max=298.92ms p(90)=49.81ms  p(95)=61.45ms
     http_reqs......................: 280     8.442988/s
     iteration_duration.............: avg=1.62s    min=1.55s  med=1.59s    max=2.14s    p(90)=1.63s    p(95)=1.68s
     iterations.....................: 56      1.688598/s
     vus............................: 1       min=0      max=5
     vus_max........................: 5       min=5      max=5
running (33.2s), 0/5 VUs, 56 complete and 0 interrupted iterations
scenarios ✓ [ 100% ] 0/5 VUs  30s
time="2024-12-19T05:50:59Z" level=error msg="thresholds on metrics 'http_req_failed' have been crossed"

出力項目の説明
無事に負荷テストを実行することができました。どの項目がどのような意味なのかわかりにくいと思うので簡単にまとめてみました。
| 項目 | 説明 |
|---|---|
| checks | テストで宣言した check() アサーションのうち、実際に完了した数 |
| data_received | 受信したデータの量 |
| data_sent | 送信されたデータの量 |
| http_req_blocked | 開始前にリクエストがブロックされた時間。このメトリックは、リクエストが送信される前の遅延を示します。これには、ネットワーク接続のセットアップにかかる時間や、以前のリクエストによる待機時間などが含まれます |
| http_req_connecting | TCP 接続の確立に費やされた時間。具体的には、テスト マシンとサーバー間の TCP 接続を確立するのにかかる時間を測定します |
| http_req_duration | HTTP リクエストの継続時間。このメトリックは、HTTP リクエストを開始してから応答が完全に受信されるまでにかかる時間を測定します |
| http_req_failed | エラーにより失敗したリクエストの割合。これは、テスト中に失敗したリクエストの数を確認するのに役立ちます |
| http_req_receiving | HTTP 応答の受信に費やされた時間。これは、サーバーからの応答データの受信にかかる時間を測定します |
| http_req_sending | HTTP リクエストの送信に費やされた時間。これには、ヘッダーと本文を含むすべての HTTP リクエスト データをサーバーに送信するのにかかる時間が含まれます |
| http_req_tls_handshaking | TLS/SSL ハンドシェイクに費やされた時間。このメトリックは、安全な通信チャネルを確立するために使用される暗号化ハンドシェイク プロセスの継続時間を報告します |
| http_req_waiting | サーバーからの応答を待つのに費やされた時間。これは多くの場合、リクエスト期間の最大の部分であり、リクエストの送信終了から応答の受信開始までの時間を測定します |
| http_reqs | HTTP リクエストの合計数。このメトリックは、テスト中に行われた HTTP リクエストの合計数を表します |
| iteration_duration | セットアップとティアダウンを含む、テスト スクリプトの 1 回の完全な反復にかかる合計時間。これは、実行された各ユーザー シナリオの開始から終了までの時間を反映します |
| vus | 仮想ユーザーの数。このメトリックは、テスト中の任意の時点でアクティブな同時仮想ユーザーの数を示します |
| vus_max | 仮想ユーザーの最大数。これは、テスト中にアクティブだった仮想ユーザーのピーク数を示します。これは、テストの規模を理解するのに役立ちます |
終わりに
いかがだったでしょうか?
JavaScriptを作る必要がありますが、JavaScriptなら学習コストも高くなく気軽に作ることができました。
また、徐々にユーザ数・リクエスト数を増やすなどのかゆいところにも手が届く印象です。
これをCIで定期的に実行させればサービスの健全性も可視化することができそうですね。よければ参考にしてみてください。
aws-advanced-jdbc-wrapperでハマったこと
ZOZO Advent Calendar 2023 カレンダー Vol.5 の 20 日目の記事です。
12/20は今年家族となった黒トイプードルの1歳の誕生日で、記念すべき日にアドベントカレンダーを書くことにしました。
Happy Birthday!!
aws-advanced-jdbc-wrapperとは
AWS Aurora MySQLを利用されている方は大変多いかと思いますが、aws-advanced-jdbc-wrapper(以下、jdbc-wrapper)はご存知でしょうか?
AWSが開発しているOSSで既存のJDBCをラップしてクラスター化されたAuroraを安全・安心、そして便利になるようにするドライバです。
プラグイン形式で必要に応じて各種機能を追加することができます。代表的なプラグイン1は以下になります。
| 機能名 | 概要 |
|---|---|
| フェイルオーバー接続プラグイン | Aurora クラスターおよび RDS Multi-AZ DB クラスターにおいてフェイルオーバー後に古いノードに接続するこを防ぐ |
| ホスト監視プラグイン | ホスト接続障害監視。より高速な障害検知を可能にする |
| IAM認証接続プラグイン | IAMを利用してAuroraクラスターに接続できるようにする |
| AWS Secrets Manager 接続プラグイン | Secrets Manager サービスからデータベース認証情報を取得 |
| 読み書き分割プラグイン | データベースのリーダーとライターのインスタンスを切り替える |
MySQLに特化したものではありますが、aws-mysql-jdbcというドライバもあります。jdbc-wrapperの方が後発になっており、プラグイン機能によってより強力になっているものと思います。
試してみる
次の環境で接続を行います。
jdbc-wrapperの設定はapplication.yamlに定義するだけで特段難しいことはありません。
spring:
  datasource:
    url: jdbc:aws-wrapper:mysql://{クラスタエンドポイント}/test
    driver-class-name: software.amazon.jdbc.Driver
    type: com.zaxxer.hikari.HikariDataSource
    hikari:
      data-source-properties:
        wrapperPlugins: readWriteSplitting,failover,efm
        readerHostSelectorStrategy: leastConnections
        failoverMode: reader-or-writer
      exception-override-class-name: software.amazon.jdbc.util.HikariCPSQLException
設定内容はマニュアルを見ていただくほうが良いかと思いますが、簡単に概要を説明します。
| プロパティ | 概要 |
|---|---|
spring.datasource.url |
JDBC URLにjdbc:aws-wrapper:mysqlを付与することでwrapperの利用を宣言する |
spring.datasource.driver-class-name |
wrapperのドライバクラスとしてsoftware.amazon.jdbc.Driverを設定する |
spring.datasource.hikari.data-source-properties.wrapperPlugins |
プラグインをカンマ区切りで指定 |
spring.datasource.hikari.data-source-properties.readerHostSelectorStrategy |
Auroraクラスタに複数のリーダーが接続している場合にどのように接続先を選択するかを指定 |
spring.datasource.hikari.data-source-properties.failoverMode |
フェイルオーバー時の挙動を指定 |
spring.datasource.hikari.exception-override-class-name |
コネクションプールがフェイルオーバー時に例外をハンドリングするために指定 |
これでbootRunを行えばMySQL Connector/Jと変わらずAuroraに接続することができます。jdbc-wrapperはAuroraを監視してくれており、定期的に障害が起きていないかSQLを実行して確認してくれています。
動かしてみよう
hogeテーブルから条件に合致する全件数と先頭5件を取得するロジックを組んでみます。細かい実装は省いていますがページング的な動きです。
sql_calc_found_rowsやfound_rows()はMySQL8以降、非推奨になってしまいましたが利用されている方は多いのではないでしょうか?便利なので利用させてもらいます。
雑に説明するとsql_calc_found_rowsはlimitを無視して件数を取得してくれる宣言で、found_rows()はそのLimitを無視した件数を取得する関数になります。
@RestController
@RequestMapping(
  value = "/hoges",
  produces = {"application/json"})
public class HogeController {
  private final HogeService hogeService;

  public HogeController(HogeService hogeService) {
    this.hogeService = hogeService;
  }

  @GetMapping
  public ResponseEntity<HogeResponse> getHoges() {
    return ResponseEntity.ok(hogeService.getHoges());
  }
}


@Service
public class HogeService {
  private final JdbcTemplate jdbcTemplate;

  public HogeService(JdbcTemplate jdbcTemplate) {
    this.jdbcTemplate = jdbcTemplate;
  }

  public HogeResponse getHoges() {
    var list = jdbcTemplate.query(
      """
        select sql_calc_found_rows
          id,
          message,
          point
        from
          hoge
        where
          point > 5
        order by
          point desc
        limit 5
        """, (rs, rowNum) ->
          new HogeEntity(
            rs.getInt("id"),
            rs.getString("message"),
            rs.getInt("point")
          )
    );

    if (list.isEmpty()) {
      return new HogeResponse(0, emptyList());
    }

    var allCount = jdbcTemplate.queryForObject(
      """
        select found_rows()
        """, Integer.class
    );

    return new HogeResponse(allCount, list);
  }
}
実行結果はこんな感じ。
❯ curl http://localhost:8080/hoges | jq
  % Total    % Received % Xferd  Average Speed   Time    Time     Time  Current
                                 Dload  Upload   Total   Spent    Left  Speed
100   212    0   212    0     0   1109      0 --:--:-- --:--:-- --:--:--  1145
{
  "allCount": 2,
  "data": [
    {
      "id": 275,
      "message": "177",
      "point": 10
    },
    {
      "id": 253,
      "message": "42",
      "point": 10
    },
    {
      "id": 249,
      "message": "87",
      "point": 10
    },
    {
      "id": 237,
      "message": "333",
      "point": 10
    },
    {
      "id": 182,
      "message": "244",
      "point": 10
    }
  ]
}
おや?
ポケモンが進化するような雰囲気ですが、上記の結果に違和感を覚えた方もいるかと思います。
dataは5件あるのにallCountが2になっていて結果に不整合が起きています。
これはfound_rows()とjdbc-wrapperの組み合わせで稀に起きる事象です。
found_rows()は最後にSELECTした行数をカウントする関数です。一方のjdbc-wrapperはAuroraの障害検知のために定期的にSQLを実行し監視を行ってくれます(発行されるSQLはこちら)。
勘のいい方ならお気づきでしょう。
そうです、sql_calc_found_rowsとfound_rows()の間でjdbc-wrapperの障害検知SQLが実行されていたのが原因でした。取得された2件はAuroraクラスタに接続されているRead・Writeの2台という意味になります。
対策はSELECT COUNTにすることで解消することができます。found_rows()はMySQL8から非推奨となっているので利用は避けるべきですね。
さいごに
発生頻度も低く特定に困難な事象でしたので、発見するまでにだいぶハマってしまいました。。
わかってしまえばなんてことないですが、ページング機能はORマッパーでサポートしていて内部的にfound_rows()を利用しているものもいくつかあるようです。
そういった場合は問題の特定に時間がかかってしまったりするので、この記事をしくじり先生として覚えておいていただけると自分の失敗も救われます。
デスクガジェット更新
ほぼ1年ぶりの更新。
今年はプライベートの時間が全く取れておらず、自己啓発的な活動ができなくてブログネタがなかった。。
そして連続ガジェット紹介になってしまいました。
前回の記事
chichi1091.hatenablog.jp
早速今回追加したものを紹介していきます
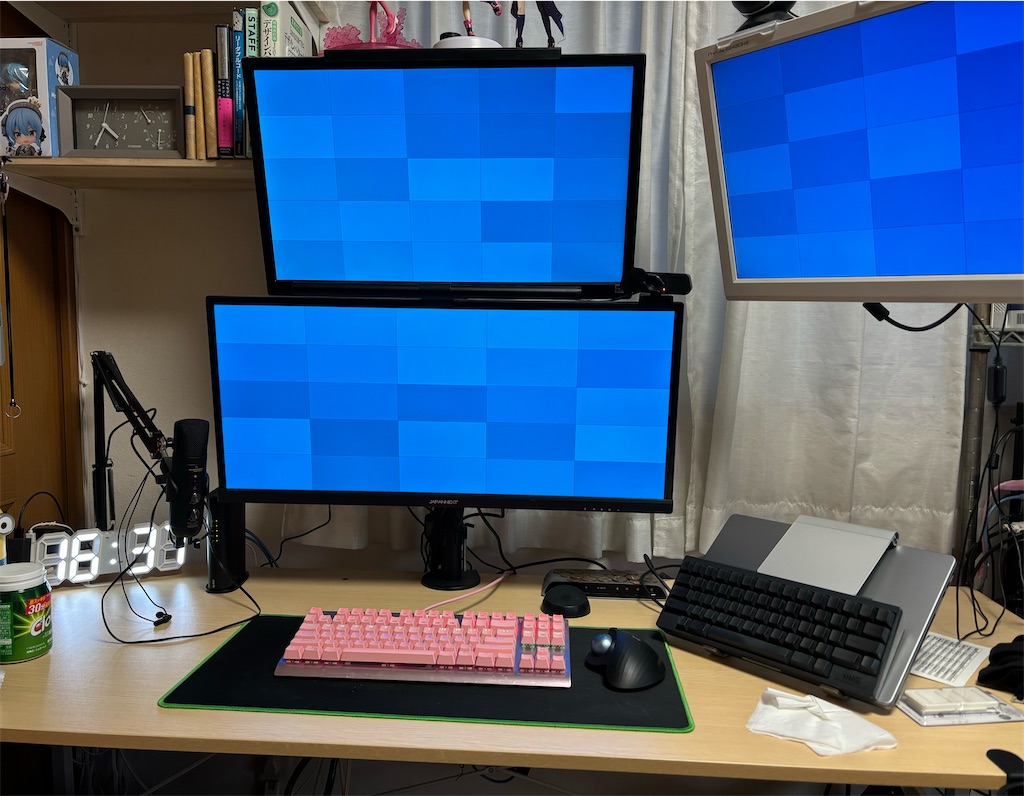
トリプルモニター化
余っていたiiyamaの24インチモニターを右上に設置してみました。
前まではデスクトップは2画面だったのが3画面になり、モニターをブラウザ専用や、IDE専用にしたり世界が広がりました。やはりモニターは何枚あってもいいですね。

モニターライト

目が疲れることが多く手元の明るさがほしいと思い購入。ワイヤレス操作でON・OFFができるのでよきです。ただ、目の疲れは変わらないのはちょっと残念。。
wi-fiルーター

我が家のwi-fiはリビングに設置されており、作業部屋からの接続だと切れることがちょいちょいあったので部屋に設置。普通に使えてます。
トラックボールマウス

デスクトップで利用していたマウスのスクロールがちゃんと動かないことがあり購入。初めてのトラックボールマウスということもあり使いこなせない。。カーソルの細かい動きが難しいし、補助ボタン(ブラウザの進む・戻る)が手が小さいのか親指が届かいと不満が。。。慣れの問題なんだろうから使い続けようと思います。
フルリモートワーカーとしてデスクガジェットはだいぶ揃って来たかな?
仕事用のmacとデスクトップ用とで分けて利用しているキーボードを一つにまとめるために、usbでも使えるHHKBに更新したい。
が、予算の都合上もうちょい先かな。。
ワイドモニターを導入して縦設置にしてみた
1年ぶりのPCネタ。
前回の記事はコチラ
chichi1091.hatenablog.jp
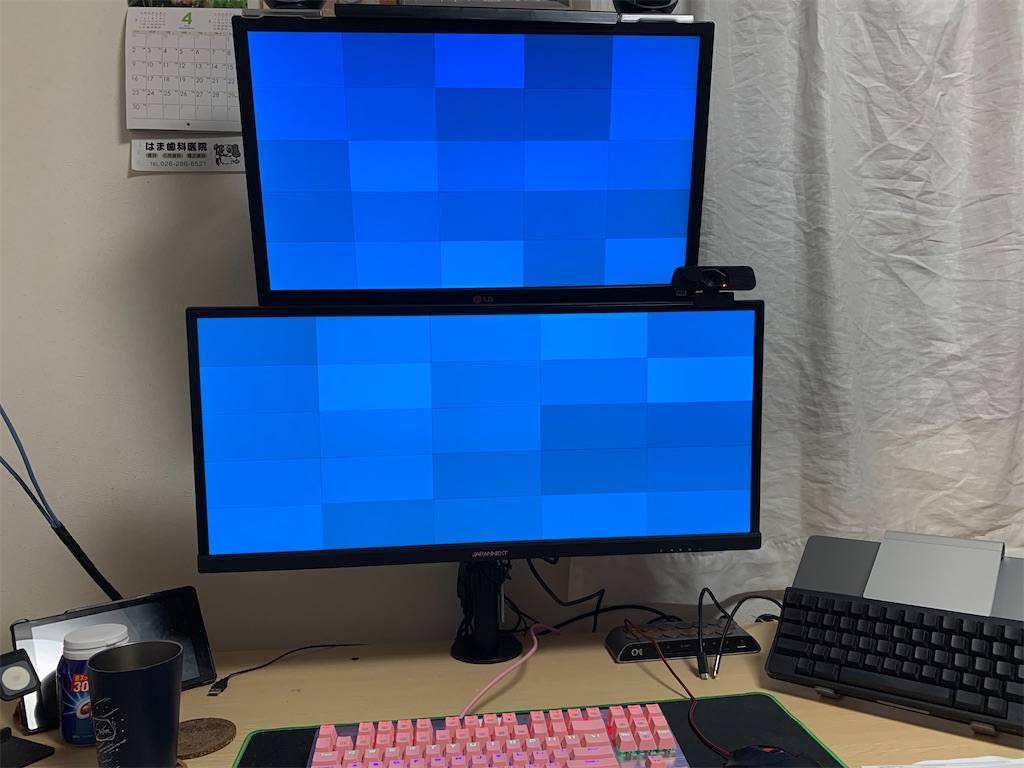
今回はワイドモニターを購入し、モニターアームも新調して縦2画面構成にしてみた。
購入したものは
japannext.net marantzpro.jp www.greenhouse-store.jp
色々調べているうちにJapanNextのモニターが勝手にウルトラワイドだと思い込んでいたようで、設置して接続してなんか違う。。ってなってしまった。
そうだよな。。この値段でウルトラワイド変えるわけないよなー。しかもUSBハブ機能もついているし。
※ウルトラワイドの解像度は29インチだと2560×1080みたいなので、これもウルトラワイドモニターのようでした。
でも購入の決め手になったのは値段の他にこのUSBハブ。
本業PCとプライベート兼副業自作PCのカメラやマイクが片方でしか使えなくていい方法ないかなーと思っていたところにモニター自体にハブがある機種があると知って購入を決めたので、これはサイコー。かんたんに切り替えができるのでこれから重宝しそう。
モニターアームは今まで横に並べていたモニターを見るのに結構首を動かす必要があってそのせいで肩こりとか起きてる気がしてので、縦設置に切り替えてみた。
これも成功で、首よりも机が広く使えるようになり、整理もしやすくなった。
上のモニターを見るのも動かす範囲が狭くなったので、これから期待。
今まで使っていたマイクがアームセットで2000円ぐらいだったためか、副業で声が聞こえないとかノイズがひどいとか色々言われていたため、購入を決めて適当に選んだ。
今の所苦情は来ていないので問題ないと思われるので、本業でも試していこうと思う。
完全なリモートワーカーになったので、自宅環境をアップグレードさせてきたけど次はネットワーク系になるのかな?
wi-fiを部屋に設置する感じかなー。嫁のチェックがあるので時間をおいてからかな。。
SpringBoot+JPAからTiDBを使ってみる
ZOZO Advent Calendar 2022 カレンダー Vol.3 の 15 日目の記事です。
前回はTiDBとMySQLの機能比較を行いました。
今回はSpringBootとJPAを利用してTiDBに接続するための方法や注意点を整理していきたいと思います。
環境
以下の環境で動作確認を行いました。
TiDBをDockerで起動する
こちらを参照にさせていただきdocker-compose.yamlを作成しました。
v5.4.0を利用していますが、M1 Macで動かす場合はv6.1.0にする必要がありましたのでご注意ください。
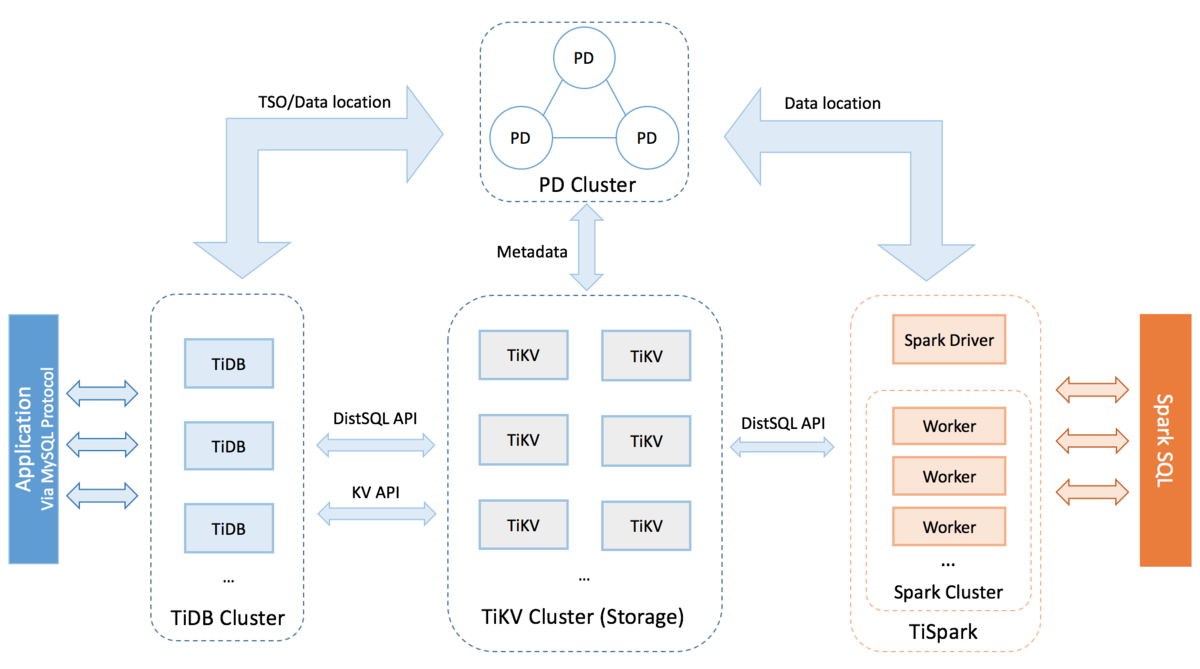
それぞれのコンテナの役割は次の図が参考になると思います。
起動をしたらデータベースとユーザを作成していきます。さすがMySQL互換のTiDB、コマンドはMySQLのコマンドと同じ。なのでMySQLユーザであればおなじみのコマンドになります。
$ mysql -h 127.0.0.1 -P 4000 -u root

mysql> create database tidb_sample CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci;
Query OK, 0 rows affected (0.10 sec)

mysql> create user tidb@'%' IDENTIFIED by 'tidbpassword';
Query OK, 0 rows affected (0.02 sec)

mysql> GRANT ALL PRIVILEGES ON * . * TO tidb@'%';
Query OK, 0 rows affected (0.02 sec)
これでTiDBの準備は完了です。MySQL Workbenchなどで接続をしてみてください。
SpringBoot
TiDBはMySQL互換なので、HibernateのMySQL dialectで接続することができるのですが、PingCAP社が作成したTiDB dialectを利用するとTiDB独自のWindow関数などの利用が行えるようになります。TiDB dialectが組み込まれたHibernateはまだspring-boot-starter-data-jpaに入っていませんので、6.0.0.Beta2以降のHibernate-Coreに差し替える必要があります。
サンプルが提供されているので簡単に行えると考えていましたが、SpringBoot3以外でHibernate-Coreの差し替えを行うと次の例外が起こりSpringBootが起動しません。。サンプルの通りTiDB dialectを利用するにはSpringBoot3を利用したほうがよさそうです。
java.lang.NoClassDefFoundError: javax/persistence/EntityManagerFactory
    at org.springframework.data.jpa.util.BeanDefinitionUtils.<clinit>(BeanDefinitionUtils.java:57) ~[spring-data-jpa-2.7.3.jar:2.7.3]
    at org.springframework.data.jpa.repository.support.EntityManagerBeanDefinitionRegistrarPostProcessor.postProcessBeanFactory(EntityManagerBeanDefinitionRegistrarPostProcessor.java:72) ~[spring-data-jpa-2.7.3.jar:2.7.3]
    at org.springframework.context.support.PostProcessorRegistrationDelegate.invokeBeanFactoryPostProcessors(PostProcessorRegistrationDelegate.java:325) ~[spring-context-5.3.23.jar:5.3.23]
    at org.springframework.context.support.PostProcessorRegistrationDelegate.invokeBeanFactoryPostProcessors(PostProcessorRegistrationDelegate.java:191) ~[spring-context-5.3.23.jar:5.3.23]
    at org.springframework.context.support.AbstractApplicationContext.invokeBeanFactoryPostProcessors(AbstractApplicationContext.java:746) ~[spring-context-5.3.23.jar:5.3.23]
    at org.springframework.context.support.AbstractApplicationContext.refresh(AbstractApplicationContext.java:564) ~[spring-context-5.3.23.jar:5.3.23]
    at org.springframework.boot.web.servlet.context.ServletWebServerApplicationContext.refresh(ServletWebServerApplicationContext.java:147) ~[spring-boot-2.7.4.jar:2.7.4]
    at org.springframework.boot.SpringApplication.refresh(SpringApplication.java:734) ~[spring-boot-2.7.4.jar:2.7.4]
    at org.springframework.boot.SpringApplication.refreshContext(SpringApplication.java:408) ~[spring-boot-2.7.4.jar:2.7.4]
    at org.springframework.boot.SpringApplication.run(SpringApplication.java:308) ~[spring-boot-2.7.4.jar:2.7.4]
    at org.springframework.boot.SpringApplication.run(SpringApplication.java:1306) ~[spring-boot-2.7.4.jar:2.7.4]
    at org.springframework.boot.SpringApplication.run(SpringApplication.java:1295) ~[spring-boot-2.7.4.jar:2.7.4]
    at com.example.TidbSpringbootJpaApplicationKt.main(TidbSpringbootJpaApplication.kt:14) ~[main/:na]
buid.gradleでは次のようにすることで差し替えることができます。
dependencies {
    implementation ("org.springframework.boot:spring-boot-starter-parent:3.0.0")
    implementation ("org.springframework.boot:spring-boot-starter-web:3.0.0")
    implementation ("org.springframework.boot:spring-boot-starter-data-jpa:3.0.0") {
        exclude group: "org.hibernate", module: "hibernate-core"
    }
    implementation ("org.hibernate.orm:hibernate-core:6.1.5.Final")
}
接続先(application.yml)
datasource にはDockerで定義した接続先を指定するだけで、MySQLのときと特に変わりはありません。JPAの database-platform にHibernateの差し替えで利用できるようになったTiDB dialectを指定するぐらいで特段注意する点はないかと思います。
spring:
  datasource:
    driver-class-name: com.mysql.cj.jdbc.Driver
    url: jdbc:mysql://localhost:4000/tidb_sample
    username: tidb
    password: tidbpassword
    type: com.zaxxer.hikari.HikariDataSource
  jpa:
    database-platform: org.hibernate.dialect.TiDBDialect
JPA
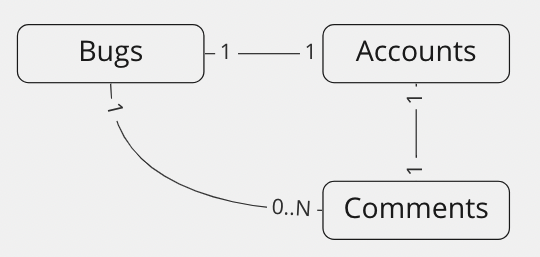
テーブルは簡単なバグトラッキングシステムをイメージした以下の3テーブルを操作することにします。
- Bugs:バグを管理するテーブル
- Comments:バグのコメントを管理するテーブル
- Accounts:アカウントを管理するテーブル
ざっくりとしたER図はこちら。
エンティティ
TiDBで auto_increment の利用ができないため自動採番を行いたい場合はシーケンスを利用する必要がありますので、 @GeneratedValue と @SequenceGenerator でシーケンスの利用を指定しています。
@Entity
@Table(name = "bugs")
data class Bugs(
    @Id
    @GeneratedValue(strategy = GenerationType.SEQUENCE, generator="bug_id")
    @SequenceGenerator(name="bug_id", sequenceName="bug_id_seq", allocationSize=1)
    @Column(name = "bug_id")
    val bugId: Int?,
    @Column(name = "date_reported")
    val dateReported: Date,
    @Column(name = "summary")
    val summary: String,
    @Column(name = "description")
    val description: String,
    @OneToOne
    @JoinColumn(name = "reportedBy", referencedColumnName = "account_id")
    val reportedBy: Accounts,
    @OneToOne
    @JoinColumn(name = "assignedTo", referencedColumnName = "account_id")
    val assignedTo: Accounts,
    @Enumerated(EnumType.STRING)
    val status: Status,
)

@Entity
@Table(name = "comments")
data class Comments(
    @Id
    @GeneratedValue(strategy = GenerationType.SEQUENCE, generator="comment_id")
    @SequenceGenerator(name="comment_id", sequenceName="comment_id_seq", allocationSize=1)
    @Column(name = "comment_id")
    val commentId: Int?,
    @ManyToOne
    @JoinColumn(name = "bug_id", referencedColumnName = "bug_id")
    val bug: Bugs,
    @OneToOne
    @JoinColumn(name = "author", referencedColumnName = "account_id")
    val author: Accounts,
    val commentDate: Date,
    val comment: String,
)

@Entity
@Table(name = "accounts")
data class Accounts(
    @Id
    @GeneratedValue(strategy = GenerationType.SEQUENCE, generator="account_id")
    @SequenceGenerator(name="account_id", sequenceName="account_id_seq", allocationSize=1)
    @Column(name = "account_id")
    val accountId: Int?,
    @Column(name = "name")
    val name: String,
    @Column(name = "email")
    val email: String,
)
これでHibernateの ddl-auto でテーブルを作成すると次のリソースが作成されました。
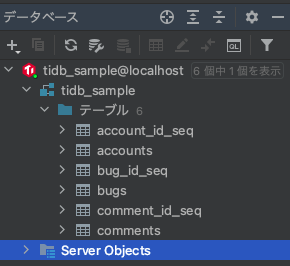
sequenceName で指定したテーブルが作られています。どうもTiDBではシーケンスはテーブルリソースとして作成され採番機能を実現しているようです。試しに account_id_seq にselectを行うと [42S02][1051] Unknown table '' とエラーが出てしまいます。 select nextval(account_id_seq); といったシーケンスを取得する関数を利用することで次の値を取得することができます。この辺はMariaDBに寄せてる感じです。
まとめ
使ってみた結果、MySQLに接続しているのとほぼ変わりなくTiDBを利用することができました。他のORマッパーでも利用することができると思いますが、TiDB dialectが吸収している差異を自力で解決する必要があるため、できるだけJPAを使うのがよさそうに思います(JPAに好き嫌いがあるとは思いますが)。
後は性能や運用面、費用で問題がなければ実運用でも十分採用することができるのではないかと感じました。2回に渡ってTiDBを調べてみましたが参考になれば幸いです。
TiDBとMySQLの機能比較
ZOZO Advent Calendar 2022 カレンダー Vol.3 の 9 日目の記事です。
久しぶりのブログ更新になります。前回からだいぶ時間が空いてしまったので定期的に書けるようにしていかないとと反省しています。。
NewDBと呼ばれる新しいデータベースが登場し利用事例が増えてきました。その中でもMySQL互換のTiDBについて耳にする機会が増えたので、MySQLとの機能比較を行ってみました。DB選定や移行検討の際にお役に立てれば幸いです。
TiDBとは
TiDBはPingCAP社が開発した分散型データベースで、RDBMSとNoSQLの機能を組み合わせたデータベースです。
MySQL互換のSQL解析機能を持っているためアプリケーションからはMySQLと同様のアクセスが可能であり、水平方向のスケーラビリティ・協力な一貫性・高可用性を兼ね備えています。
MySQLとTiDBの比較
アプリケーションから利用する際の機能比較になります。インフラ・運用面、費用などは利用する環境によってパターンが多く出てしまうため、対象外とします。
トランザクション分離レベル
(一つの表にまとめるのが困難だったので別途切り出してます...)
- ダーティリード:コミットされていないデータを別トランザクションで読めてしまう
- ノンリピータブルリード:コミットされたデータを別トランザクションが読めてしまう
- ファントムリード:取得したデータに対して別トランザクションがInsert or Deleteしてコミットすると同じ条件で読み込むとデータが増減している
MySQL8
| ダーティリード | ノンリピータブルリード | ファントムリード | |
|---|---|---|---|
| READ UNCOMMITTED | ◯ | ◯ | ◯ |
| READ COMMITTED | ◯ | ◯ | |
| REPEATABLE READ (デフォルト) |
|||
| SERAIALAZABLE |
TiDB
| ダーティリード | ノンリピータブルリード | ファントムリード | |
|---|---|---|---|
| READ UNCOMMITTED | ◯ | ◯ | ◯ |
| READ COMMITTED | ◯ | ◯ | |
| REPEATABLE READ (デフォルト) |
◯ | ||
| SERAIALAZABLE |
- MySQL(InnnoDB)はREPEATABLE READでファントムリードが発生しない
- TiDBはREPEATABLE READでファントムリードが発生する
- TiDBトランザクション分離レベル
その他
| 項目 | MySQL8 | TiDB | 備考 |
|---|---|---|---|
| DDL |
|
||
| 権限 |
|
||
| 文字コードと順序 |
|
|
|
| 索引 (index) |
|
||
| 一時テーブル (temporary) |
|
||
| ビュー (view) |
|
||
| 分割 (partition) |
|
||
| 自動採番 (auto increment) |
|
||
| 外部キー (foreign key) |
|
||
| ユニーク制約 (unique index) |
|
||
| 検査制約 (check) |
|
||
| 型 (data type) |
|||
| 結合 (join) |
|
||
| トリガー (trigger) |
|
||
| ストアドプロシージャ、関数 (procedure/function) |
|
||
| 集計関数 (window function) |
|
|
まとめ
MySQL5.7をベースにしているだけあってMySQLと同等のことが行えそうです。ただ、
- 外部キーの動作
- auto increment
は、データの整合性・値を別途取得するなど、アプリでの対応が必要となり移行の際に改修ゼロとまではいかなそうです。外部キーはプロジェクトのルールで必須となっている場合もあるかと思うので、使えないのは厳しいかもしれませんね。 とは言いつつもここまで互換性があると、書き込み性能に困っているアプリケーションの移行先にTiDBが選ばれるのも分かる気がします。近い将来、機能差異もなくなるのではないかと思うと今後の動向を注目ですね。
次回はアプリケーション(SpringBoot+JPA)からTiDBを利用する記事を書こうと思います。
